英伟达扩展RTX本地模型支持,FLUX 3优化版可在8GB显存配置运行
2026年10月21日,英伟达公布新一轮RTX本地AI模型支持与推理优化。其中,FLUX 3 Image Klein的英伟达优化构建可在显存低至8GB的GeForce RTX显卡上运行;面向编程的Recursive Flint也将GeForce RTX和RTX PRO列为运行平台。
FLUX 3优化版覆盖8GB显存配置
Black Forest Labs的FLUX 3 Image Klein是一款56亿参数的开放权重模型,可用于图像生成与编辑。本次扩展支持的重点是提供经过优化的构建,让更多GeForce RTX用户能够在本地使用这类图像模型。8GB显存条件针对该优化构建,不能套用到本轮公布的所有模型。
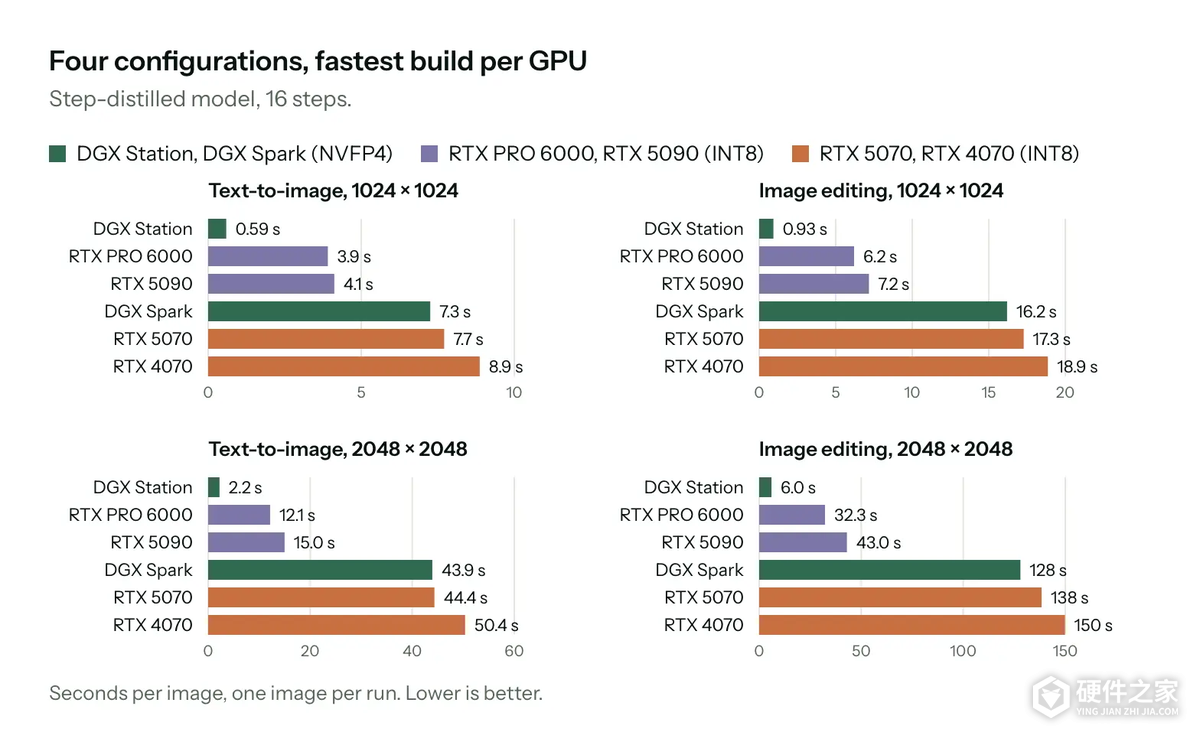
英伟达称,在RTX 5090上生成一张约100万像素的图像需要约4秒。公布的对比图进一步列出:所用为步数蒸馏模型,RTX 5090使用INT8构建、16步采样,生成1024×1024图像,每次运行一张,耗时4.1秒。这是厂商给出的特定配置结果,不能理解为8GB显卡也能达到同样速度。
编程模型与专业显卡的支持条件另行区分
Recursive Superintelligence当天发布的Recursive Flint采用混合专家架构,总参数量为400亿、活跃参数量为25亿。模型开放权重可通过Hugging Face获取,采用Apache 2.0许可证,支持在GeForce RTX及RTX PRO GPU上运行。25亿指活跃参数量,不是模型全部权重的规模,不能把FLUX优化版的8GB条件当作Flint的显存要求。
英伟达还发布了针对本地硬件内存效率优化的量化检查点。其中,Qwen3.8-Flash-Next-FP4-Local列出的单卡平台为RTX PRO 6000。它与面向8GB GeForce RTX的图像模型配置不同,不能仅凭同属本地AI更新就互相替代硬件要求。
推理引擎方面,llama.cpp新增针对Qwen 3.8 Flash Next、带MTP的推测解码支持,英伟达展示的对应GPU为RTX PRO 6000 Blackwell。这项优化针对明确的模型、引擎和硬件组合,不代表所有RTX显卡或所有推理任务都获得相同收益。
本轮涉及模型、优化构建和推理引擎多个层面,公告没有给出覆盖所有GeForce型号、操作系统和软件版本的统一兼容表。具体部署仍需匹配对应模型的构建与运行环境。
-
蓝屏代码0x00000097表示BOUND_IMAGE_UNSUPPORTED,意味着在尝试加载或运行由BIND指令绑定的文件时,操作系统遇到不支持的文件格式或属性。这种情况可能会导致系统崩溃并显示蓝屏错误。要解决这个问题,可以尝试以下方法:方法一:扫描病毒和恶意软件有时,恶意软件或病毒也会导致蓝屏错误,运行可靠的安全软件进行全面扫描以

-
SDL2_image.dll是一个用于SDL2开发的扩展库,可以让SDL2应用程序增加支持各种常见的图像格式的能力,如PNG、JPG、GIF、BMP等。使用SDL2_image.dll,开发者可以轻松地在自己的SDL2应用程序中快速加载、显示和处理各种图像格式的图像。SDL2_image.dll可以工作在多平台上,例如Windows、Linux、Mac OS X等,与SDL2的跨平台特性
-
蓝屏代码0x000000A2代表MEMORY_IMAGE_CORRUPT,这意味着系统检测到操作系统映像中的内存数据损坏。该错误可能是由于软件或驱动程序问题、硬件故障或操作系统本身的缺陷引起的。当检测到内存图像损坏时,Windows会为了保护系统稳定性而触发蓝屏错误。要解决这个问题,可以尝试以下方法:方法一:禁用或卸载可能引起冲突的软
-
蓝屏代码0xC0000221代表STATUS_IMAGE_CHECKSUM_MISMATCH,这表示在加载操作系统或其他系统组件时出现了文件校验和不匹配的问题。校验和是一种用于验证文件完整性的安全机制,它计算文件内容并与预期的校验和进行比较。如果校验和不匹配,就会触发此蓝屏错误,表明文件可能已损坏、被修改或存在其他错误,导致无法正确加载并
-
Image.dllapp是一款用于处理图片的软件。它是一款轻量级应用,安装简单方便。通过它,您可以进行如下操作:1.图片剪裁:选择需要剪裁的部分,然后将其保存为一个新的图片。2.图片旋转:您可以将图片旋转90度,180度或270度,来满足您的需求。3.图片格式转换:您可以将图片转换成不同的格式,包括JPEG、PNG和GIF等。4.图片缩
-
pdf2image.dll丢失怎么修复这个问题一直困扰着许多新手用户,常常不知道如何解决,这个问题的原因是什么,很多小伙伴都不清楚,小编为此给大家整理关于pdf2image.dll丢失怎么修复详细教程,感兴趣的快来看看吧。 首先,我们需要了解pdf2image.dll是何种文件。pdf2image.dll是一种动态链接库文件,用于将PDF文件转换为图像格
-
如果您遇到了image2pdf.dll文件丢失的问题,可以尝试以下解决方法:image2pdf.dll可能是某个软件程序的一部分。如果您知道哪个软件程序使用了该文件,可以尝试重新安装该软件程序,以便恢复丢失的文件。下载并安装缺失的DLL文件如果您知道DLL文件的来源,可以尝试从互联网上下载相应的DLL文件,然后将其复制到系统目录下,
-
PDF2Image.dll是一个用于将PDF文件转换为图像文件(如JPEG、PNG、TIFF等)的动态链接库。它提供了一组API,用于从PDF文件中读取和提取内容,并将其转换为不同格式的图像文件。该库可用于将PDF文件嵌入Web页面或应用程序中,以便于用户查看和检索。方法一、手动下载修复(不推荐,操作繁琐复杂) 1、从本站下载pdf2image.dll
-
三星最新手机——三星Galaxy Z Fold 3/Flip 3,参考之前的售价必然是不会便宜的。目前在印度开始预订,相关的售价也是被爆料了出来,到底需要多少软妹币呢?一起来看看下面的介绍吧 印度预订价格: 三星 Galaxy Z Fold 3的起售价暂定为135000印度卢比(折合人民币约11758.5元) Galaxy Z Flip 3售价在80000至90000印度卢比
-
现在要说到vivo TWS 3 Pro与TWS 3,大家都知道是昨天刚发布的新款耳机。在一个相同系列下,那么两者之前有什么区别呢?不如我们今天就来一起讨论下,拿出一个明显的结论,这样方便正在纠结的童鞋如何下手选购。 vivo TWS 3 Pro与TWS 3有哪些区别 vivo 昨晚发布的 TWS 3 系列耳机,两款都是白色,TWS 3 配色名叫「月光」、TW
-
华为荣耀最新推出了——荣耀 Magic 3,共有三个版本可供选择:荣耀 Magic 3 / 3 Pro / 至臻版,这三个版本具体有啥区别呢?谁更值得入手呢?想必大家也在为此犹豫不决,今日x小编我就来为大家解答疑惑 存储和价格方面: Magic3可选8+128GB(4599元)、8+256GB(4999元),可选黑白蓝金四色 Magic3 Pro可选8+256GB(5999元)
-
华为手环3/华为手环3Pro功能很强大,被大家形容成无所不能。如果告诉你还可以离线使用支付宝,你会觉得是不是很强大呢?那小编下面就来教大家如何设置,当然这个设置方便有两种你根据自己的需求进行一个选择: 方式一:不存入零花钱绑定 1、开启手机蓝牙,在手环主界面点击支付宝,在“支付协议”界面中点击同意协议,手环