英伟达详解推理内存分层,Dynamo复用跨层KV缓存
英伟达11月5日介绍GPU、CPU、网络、存储和软件的协同设计,说明如何通过压缩与跨层迁移,缓解模型权重和KV缓存对GPU高带宽内存HBM的占用。Dynamo负责将不同存储层中的KV缓存作为统一资源管理,复用已经计算过的上下文。
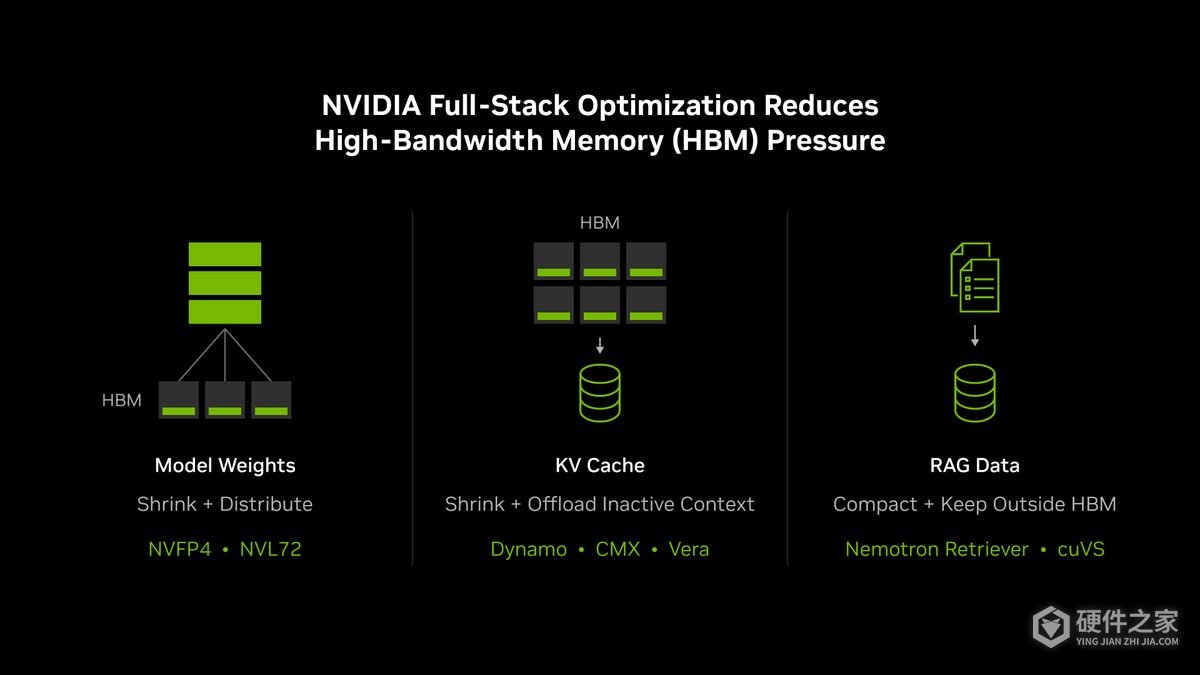
推理过程中,HBM主要存放模型权重与KV缓存。模型变大、上下文变长,以及智能体多次调用工具,都会增加需要保留的数据。CPU内存、本地SSD和共享存储提供了容量更大、每比特成本更低的层级,活跃数据留在靠近GPU的位置,暂时不用的内容迁往其他层。
权重方面,NVFP4相比FP8减少存储占用,NVL72系统还可将权重分散到最多72块GPU上,让每块GPU只保存其中一部分,为KV缓存和并发用户腾出HBM空间。
Vera CPU的大容量LPDDR内存通过NVLink-C2C与Rubin GPU连接,可暂存等待使用的上下文。CPU更快完成工具调用,也能缩短相关KV缓存的闲置时间。
上下文不活跃期间,Dynamo可将其转移至CMX上下文存储,并在复用前调回。CMX供多台服务器共享,服务于短期上下文,省去这类临时数据不需要的长期保护开销。Dynamo的KV Cache Reuse则把GPU内存、CPU内存和存储中的缓存统筹起来,让一次计算得到的上下文能够再次使用。
检索增强生成RAG的数据也有相应安排。Nemotron Retriever生成更紧凑的嵌入向量,cuVS支持在CPU和存储层构建及提供索引服务。知识库索引留在HBM之外,只有模型需要的段落进入上下文。
-
大家都知道显卡使用一段时间后,驱动也要随时保持更新,通过不断优化与完善,这样才能在最佳效果上使用。那么,你们知道英伟达显卡怎么更新驱动吗?似乎这个也是不少人的一个操作难点,那我们一起来看看吧! 英伟达显卡怎么更新驱动 1、首先右击“此电脑”点击“属性”。 2、再点击右边的“设备管理器”。 3、然后点击“显

-
英伟达显卡可以录屏?没错,相信这个功能还有不少人不知道,或者不会用。现在录屏应该是一个非常有用的功能,那不如一起跟着小编学习一下,正巧这个是非常不错的技能哦! 英伟达显卡录屏方法 1、首先右击NVIDIA图标。 2、选择“NVIDIA GeForce Experience”。 3、然后点击设置的图标。 4、在设置中把“游戏内覆盖”打开。 5
-
很显然大家收到风了,知道英伟达新版RTX 6000工作站显卡即将上市了。既然是显卡,当然肯定很多人感兴趣,如果要说这是一个专业级别的显卡的话,大家更加好奇的一定是它的实力如何。 那么最简单的方法莫过于看看,配置参数怎么样不是吗?拿好,请大家直接从数据中寻找你们想要的答案吧! rtx6000显卡参数一览 芯片厂商:NVID
-
既然说英伟达RTX 4070是我们明年见的朋友,那么新朋友之间是不是得了解一下呢?今天我们来给大家介绍的就是英伟达RTX 4070参数规格,就当是一次初次的认识吧! 英伟达RTX 4070参数规格 据爆料,RTX 4070 将采用 AD104-250-A1 芯片,拥有 5888 CUDA 核心,配备 12GB 21Gbps GDDR6X 显存,功耗为 250W。 我们了解到,爆料人 K
-
每一款显卡的发售都是让我们无比兴奋的,说明着一次次的飞跃,特别是英伟达等这种显卡大厂商,期待值绝对不会低的。那么,今天我们来揭晓的是,英伟达RTX 4080到底怎么样 英伟达即将发布的 RTX 4080 显卡可能有 12 GB 显存和 16 GB 显存两种版本。 RTX 4080 的 12GB GDDR6X 显存的参考设计将采用 10 层PCB,而 16GB 显存型
-
相信如果你问到这个问题的话,估计应该是一个玩家了,但是道行还不算深。毕竟你在使用电脑玩一些游戏或者运行视频的时候,对于帧数要求还是挺高的。那么你知道如何打开呢?其实没有你想象中那么复杂,其实只要在N卡驱动自带的GEFORCE ERPERIENCE中就可以显示帧数。 如果不会的话,也别着急,马上就来教你一招! 英伟达显卡
-
英伟达 TITAN RTX 显卡大家都听说过,但是庐山真面很少人见过。毕竟还没发布的显卡,保持神秘正常。那么,你们知道今天小编给你们带来什么吗?没错,那就是英伟达 TITAN RTX 显卡渲染图,这下子起码你可以知道,它长什么样了,期待不? 英伟达 TITAN RTX 显卡渲染图 从外观来说,你感觉怎么样呢?起码从目前资料来说,这款
-
英伟达的实力绝对毋庸置疑,在周二的时候相信你们也关注到了,英伟达发布了一款升级版的超级新品平台。怎么样是不是对于它产生了好奇,到底这是一个什么样的新产品呢?到底怎么样呢?今天这个就是我们说道说道的重点内容。 英伟达超级芯片怎么样 这款平台是专为人工智能和高性能计算设计的。和初代不同的地方在于,它使用了
-
显卡功耗电源,这些词汇都是经常玩显卡童鞋必备的知识。那么当英伟达发布了全新的产品,大家会条件反射性的想起相关问题。那么作为最新发布的英伟达rtx4090需要用多大电源呢? 英伟达发布RTX4090的时候,表示需要搭配850W电源。从官方推荐来看,850W似乎并不是特别夸张。不过随着RTX4090的发售日逐渐临近,显卡厂商发布了RT
-
有的时候,我们看到最新消息发现显卡升级版本后,会给带我们一些惊喜,例如更新了全新的功能。让我们无比跃跃欲试,想要体验。但是,试试还是尝试后才知道,升级后无法适应就动了想要退回上一个版本的想法。但,就在这个时候,大家就陷入困局了。 今天小编就是来解救大家,教大家英伟达显卡怎么退回到原来版本方法,不如一
-
在4月13日英伟达RTX 4070显卡就要发布了,之前就一直有传言说会出2个版本。如今在发布之前,小编就给大家带来点小道消息,相信大家是感兴趣的。 英伟达RTX 4070显卡有几个型号 根据爆料人“momomo_us”的线索,英伟达 RTX 4070 显卡将有高端和标准两个版本,前者使用最新的 16pin 供电接口,后者使用传统的单 8pin。 如上图
-
对于RTX 4090 Ti来说,应该可以说是江湖始终有它的传说。既然这样的话,我们一起来说点不是传说的。这不,有人曝光了RTX 4090 Ti显卡参数信息,难道你不想抢先一睹吗? 英伟达 RTX 4090 Ti 显卡怎么样 按照爆料信息,RTX 4090 Ti 将拥有 18176 CUDA 核心,配备 96MB L2 缓存,搭载 24GB 24Gbps 的 GDDR6X 显存,功耗 600W。